사내 PDF를 이미지 그대로 검색하려면: pplx-embed-v2-late 점검 항목
Perplexity가 10월 7일 공개한 pplx-embed-v2-late로 OCR 없이 페이지 이미지를 색인하는 방식과 단일 벡터 방식의 차이, 도입 전 점검 항목을 정리했습니다.
최재현 · 2026.10.09
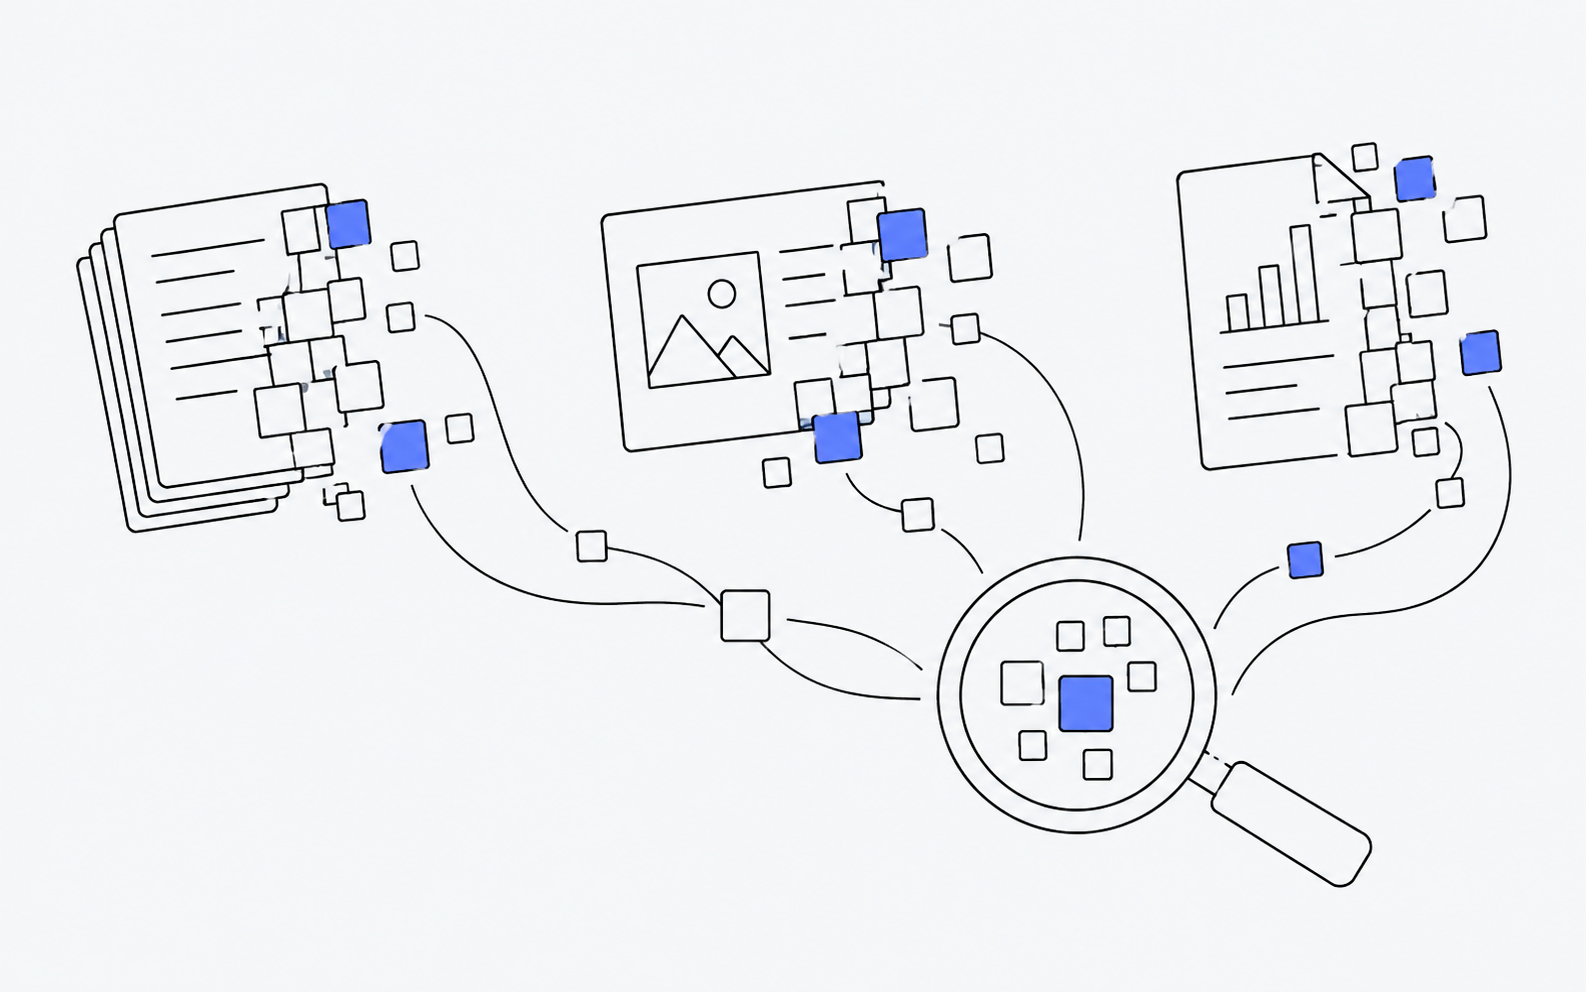
스캔한 계약서나 표와 그림이 많은 발표 자료는 사내 검색에 넣기 까다롭습니다. 글자를 뽑아내는 단계에서 내용이 빠지거나 틀릴 수 있기 때문입니다. Perplexity는 2026년 10월 7일 공식 블로그에서 late-interaction 임베딩 모델 묶음 pplx-embed-v2-late를 공개하고, 이 모델이 렌더링된 PDF 페이지를 OCR(이미지 속 글자를 읽어 텍스트로 바꾸는 처리)이나 텍스트 추출 없이 바로 검색할 수 있다고 밝혔습니다. 사내 문서 검색이나 RAG(검색한 자료를 근거로 AI가 답하게 하는 구성)를 맡은 분이 이 방식을 검토할 때 무엇이 다르고 무엇을 점검해야 하는지 정리했습니다.
1. Perplexity가 발표한 내용
Perplexity 공식 블로그는 기존 임베딩 모델 계열에 late-interaction 모델 묶음인 pplx-embed-v2-late를 더한다고 밝혔습니다. 임베딩 모델은 문장이나 이미지를 숫자 목록(벡터)으로 바꿔, 뜻이 비슷한 자료끼리 가까운 값을 갖게 만드는 모델입니다. 블로그에 따르면 새 모델은 이전 모델의 텍스트 대 텍스트 검색에 더해 텍스트로 이미지를 찾는 검색을 처리합니다.
모델 크기는 0.6B와 9B 2가지입니다. Perplexity는 품질, 응답 지연, 연산 자원 요구가 서로 다른 상황을 지원하려고 크기를 나눴다고 설명했습니다. 두 모델은 Hugging Face에 공개됐고 sentence-transformers 6.0.0 이상, transformers 5.4.0 이상과 바로 호환된다고 적혀 있습니다. Perplexity API Platform 지원은 순차적으로 제공하겠다고만 밝혀 제공 날짜와 요금은 확인할 수 없습니다. 지역 제한에 대한 언급은 없습니다.
성능 수치는 회사 자체 측정입니다. Perplexity는 시각 문서 검색 벤치마크 ViDoRe(V3)에서 0.6B 모델이 활성 파라미터가 5배인 모델과 비슷한 결과를 냈다고 발표했습니다. 비교 대상 모델과 세부 점수는 이 글에서 다루지 않았고, 한국어 문서나 이미지 검색 성능은 원문에 별도 수치가 없습니다.
2. 벡터 1개로 요약하는 방식과 토큰별 벡터 방식
렌더링된 PDF 페이지를 OCR 없이 검색한다는 점, late-interaction 모델이라는 점, 0.6B와 9B 모델 크기는 Perplexity 공식 블로그에 적힌 사실입니다. 단일 벡터 방식과 조각별 비교 과정의 그림은 일반적으로 알려진 방식을 작성자가 단순하게 그린 것이며, 질문 예시는 교육용 예시입니다. Perplexity 모델의 실제 점수 계산 세부는 이 그림에 담지 않았습니다.
많이 쓰는 임베딩 검색은 문서 하나를 벡터 1개로 요약하고, 질문도 벡터 1개로 바꿔 둘을 한 번 비교합니다. 계산이 단순한 대신 긴 문서나 표가 많은 페이지는 여러 내용을 숫자 목록 1개에 눌러 담아야 합니다. late interaction은 일반적으로 문서를 잘게 나눈 토큰(글자 조각이나 이미지 조각)마다 벡터를 남겨 두고, 검색할 때 질문의 조각과 문서의 조각을 서로 맞대어 점수를 매기는 방식을 말합니다. Perplexity도 발표 글 제목을 Multimodal embeddings beyond a single vector(단일 벡터를 넘어선 멀티모달 임베딩)로 붙였습니다.
예를 들어 "2분기 반품 사유"라는 질문이 들어오면, 토큰별 방식은 "반품"과 "사유"와 "2분기"가 페이지의 어느 부분과 가장 잘 맞는지를 따로 확인합니다. 작성자는 이 차이가 표 한 칸이나 그림 설명처럼 페이지 일부에만 답이 있는 문서에서 드러날 가능성이 크다고 봅니다. 다만 우리 문서에서도 그런지는 직접 재 봐야 합니다.
3. OCR 없이 이미지로 색인할 때 달라지는 것
지금까지 스캔 문서를 검색에 넣으려면 OCR로 글자를 뽑고, 그 텍스트를 다시 벡터로 바꾸는 단계를 거쳤습니다. 페이지 이미지를 그대로 색인(검색할 수 있게 미리 정리해 저장하는 일)하면 OCR 단계를 빼고 시작할 수 있습니다. OCR이 글자를 잘못 읽어 검색에서 빠지는 문제는 이 단계에서 생기지 않습니다.
대신 검색 결과로 텍스트 대신 페이지 이미지가 돌아온다는 점을 계획에 넣어야 합니다. RAG에서 답을 만드는 모델이 이미지를 읽을 수 있는지, 사용자에게 보여 줄 때 페이지 번호와 파일 위치를 함께 보여 줄 수 있는지 작성자는 먼저 확인하기를 권합니다. 이 부분은 Perplexity 발표가 다루지 않은 범위입니다.
4. 도입 전 점검 항목
| 점검 항목 | 확인할 내용 | 공식 발표에서 확인한 범위 |
|---|---|---|
| 한국어 문서 품질 | 우리 스캔 문서와 실제 질문으로 시험 | 별도 수치 없음 |
| 모델 크기 | 0.6B와 9B 가운데 장비와 응답 속도에 맞는 쪽 | 품질·지연·연산 요구에 맞춰 2가지 공개 |
| 벡터 저장소 | 문서 하나에 벡터 여러 개를 저장하고 비교할 수 있는지 | 저장 용량 수치는 이 글에서 확인하지 못함 |
| 실행 방식 | 직접 설치할지, API를 기다릴지 | Hugging Face 공개, API는 순차 제공 예정·날짜 미정 |
| 라이브러리 | 사내 환경의 버전 | sentence-transformers 6.0.0 이상, transformers 5.4.0 이상 |
| 라이선스 | 상업 이용 조건 | 이 글에서 확인하지 못함 |
벡터 저장소 항목은 작성자가 덧붙였습니다. 토큰별 벡터를 쓰는 구조라면 지금 쓰는 벡터 DB가 문서마다 벡터 1개를 전제로 설계됐는지부터 확인해야 합니다.
5. 이번 주에 해 볼 일
지금 검색이 잘 안 되는 문서를 골라 20쪽 정도를 모으십시오. 스캔 문서, 표가 많은 보고서, 그림 위주 발표 자료를 섞으면 좋습니다. 그 문서로 실제 동료들이 던질 법한 질문 10개를 적고, 질문마다 정답이 들어 있는 페이지 번호를 표시해 두십시오. 이 질문과 정답표가 있으면 지금 쓰는 검색과 새 방식을 같은 기준으로 비교할 수 있고, 한국어 문서에서 실제로 차이가 나는지 숫자로 확인할 수 있습니다.
참고한 자료
- Multimodal embeddings beyond a single vector - Perplexity, 2026년 10월 7일 발표
- perplexity-ai/pplx-embed-v2-late-0.6b - Perplexity 공식 Hugging Face 모델 카드, 발표일 표시 없음